FunBench:多模态大模型眼底图像解读能力基准——论文阅读笔记
AI 翻译说明: 本文由 OpenAI Codex 根据英文原文翻译,并保留原文的结构、论点、公式与参考文献。
- 论文: FunBench: Benchmarking Fundus Reading Skills of MLLMs
- 作者: Qijie Wei、Kaiheng Qian、Xirong Li
- 会议/年份: MICCAI 2025
- 代码/数据: GitHub 仓库 · Hugging Face 数据集
摘要
FunBench 是一个新颖的分层数据集与基准,用于评估开源多模态大语言模型(MLLM)在不同难度眼底图像解读任务上的有效性。代码与数据已发布在 GitHub 和 Hugging Face。1
1. 为什么这篇论文值得关注
这篇论文为评估 MLLM 的眼底图像解读能力提供了一个结构化基准。其任务框架也可为眼科智能体工作流的评估,以及其他领域基准的开发提供参考。1
2. 背景与动机
2.1 背景与问题
尽管医学 MLLM 研究正在快速增长,但面向眼科学的基准开发仍然相对滞后。1
2.2 既有工作的空缺
作者认为,OmniMedVQA 和 GMAI-MMBench 等既有医学基准将基于视网膜图像的视觉问答(VQA)视为单一任务,因此缺乏对眼底图像解读技能的详细、结构化评估。1 4 5
作者将 LMOD 描述为一个更细致的眼科基准,评估视杯、视盘和中央凹的识别,以及青光眼和黄斑裂孔的识别。他们认为,FunBench 与 LMOD 的区别在于分层任务组织和针对性评估模式。1 6
3. 核心贡献
- 设计了分层任务体系,范围从低层次的成像模态与解剖感知,到高层次的病变分析和疾病诊断。
- 引入三种评估模式,旨在评估视觉编码器(VE)、大语言模型(LLM)和完整的 MLLM。1
4. 方法
4.1 概览
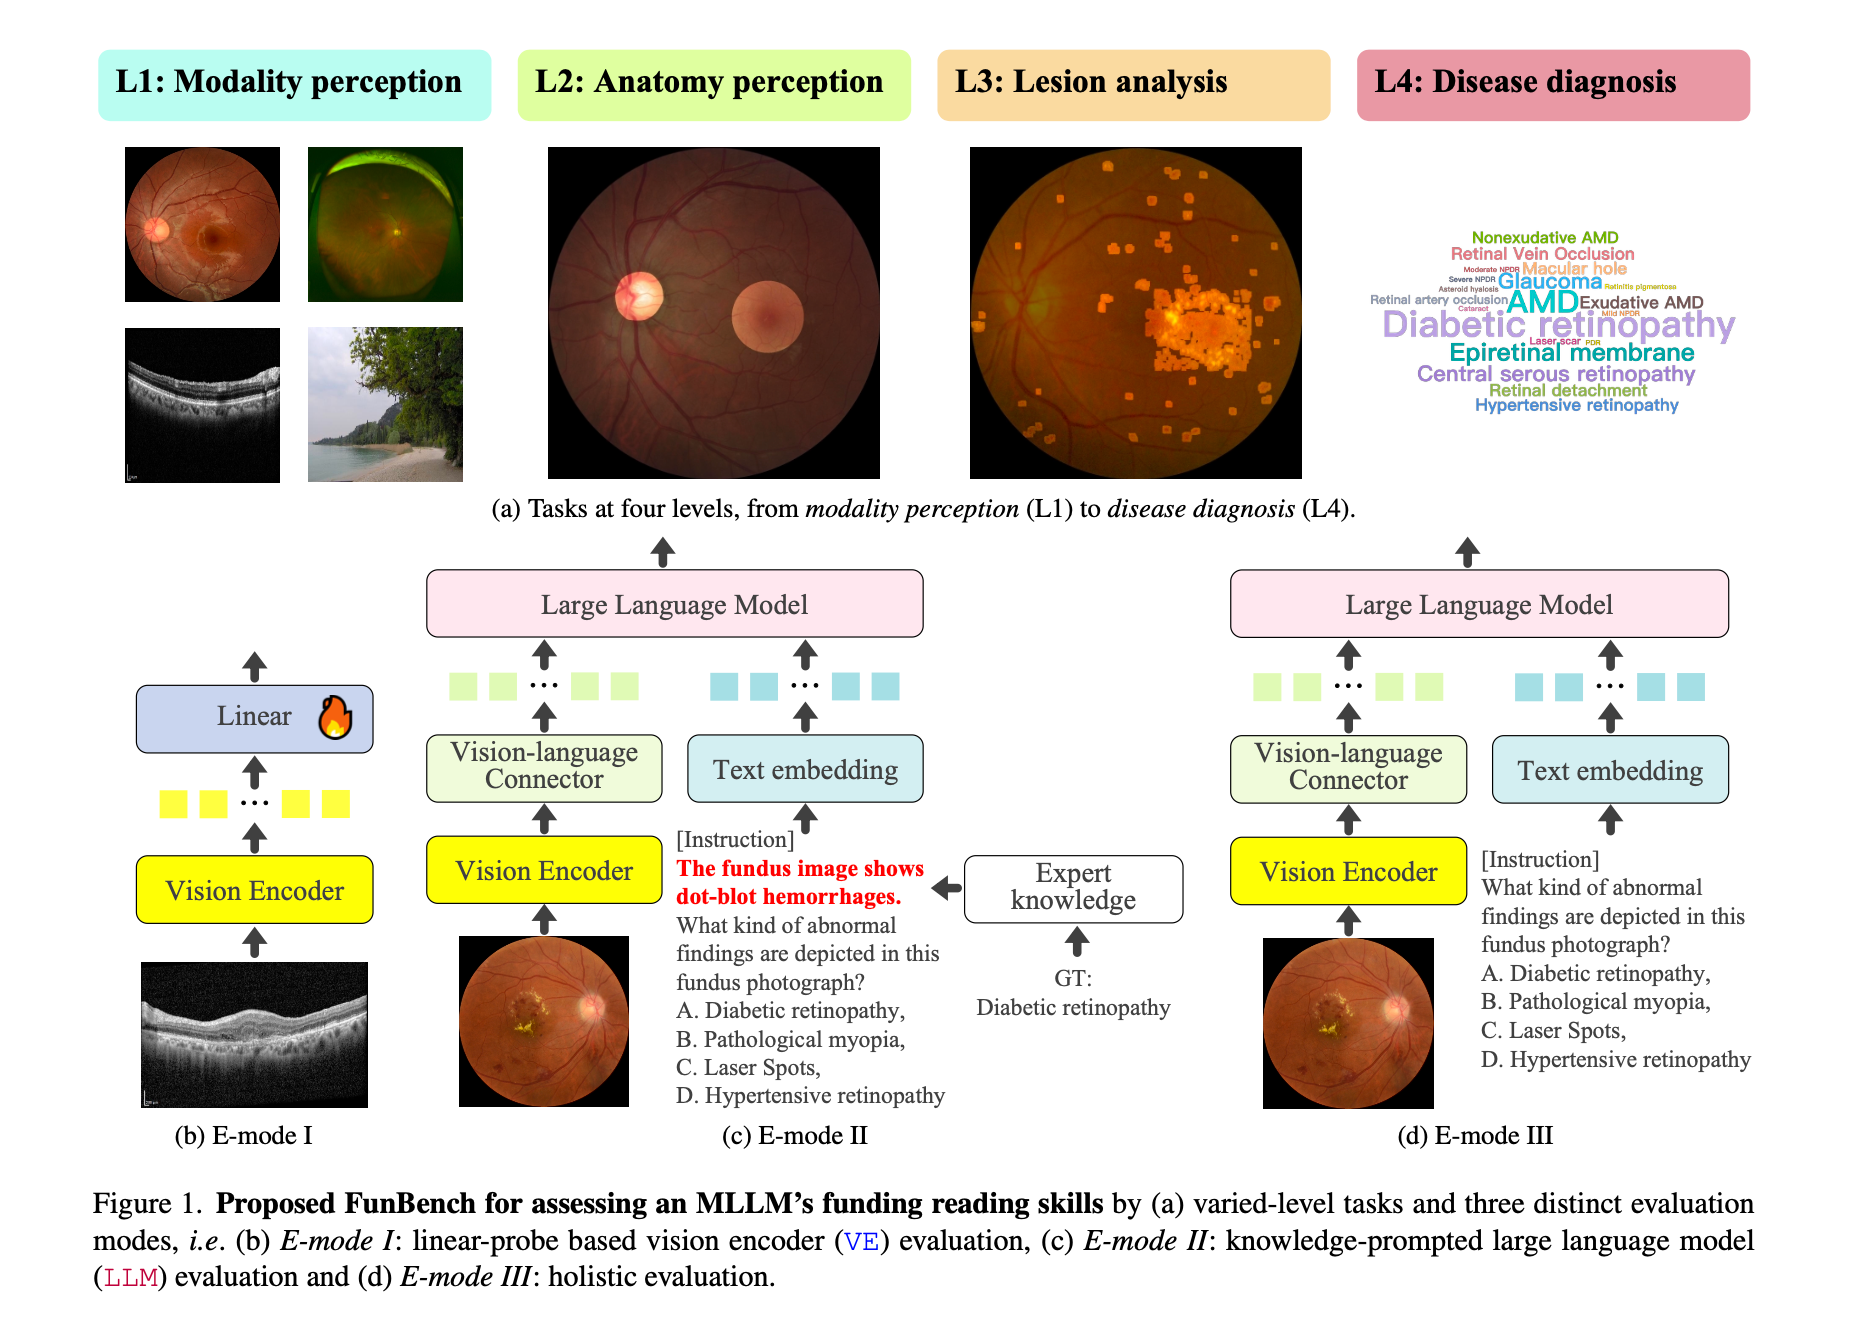
FunBench 将眼底图像解读组织为四个层级,并通过三种针对性评估模式评价 MLLM。1
4.2 数据集构建
4.2.1 分层任务组织
以下示例问题根据任务模板改写,以便阅读。实际评估应使用已发布的标注。3
层级 1(L1):成像模态感知
-
L1a:粗粒度成像模态感知
请根据图像与问题选择最合适的选项,并直接回答选项字母。
问题: 这里呈现的是什么类型的图像?
选项: A. 眼底图像;B. 遥感图像;C. 绘画;D. 全切片图像。 -
L1b:细粒度成像模态感知
请根据图像与问题选择最合适的选项,并直接回答选项字母。
问题: 这幅图像采用了哪种成像技术?
选项: A. 超广角眼底摄影;B. 超声;C. 眼底荧光血管造影;D. X 射线。
层级 2(L2):解剖感知
-
L2a:判断视盘与中央凹的相对位置
请根据图像与问题选择最合适的选项,并直接回答选项字母。
问题: 视盘和中央凹中,哪一个位于左侧?
选项: A. 视盘;B. 中央凹。 -
L2b:识别眼底图像的左右眼别
请根据图像与问题选择最合适的选项,并直接回答选项字母。
问题: 这幅图像显示的是左眼还是右眼?
选项: A. 左眼;B. 右眼。
层级 3(L3):病变分析
-
L3a:病变识别
请根据图像与问题选择最合适的选项,并直接回答选项字母。
问题: 这幅眼底图像是否显示纤维增殖的证据?
选项: A. 否;B. 是。 -
L3b:病变定位
请根据图像与问题选择所有合适的选项;如有必要,请用逗号分隔选项字母并直接作答。
问题: 这幅眼底图像中的纤维增殖位于哪里?
选项: A. 视盘中心颞侧;B. 视盘中心鼻侧;C. 图像中未见;D. 视盘中心下方;E. 视盘中心上方。 -
L3c:病变大小估计
请根据图像与问题选择最合适的选项,并直接回答选项字母。
问题: 眼底照片中纤维增殖的面积是多少?
选项: A. 图像中未见;B. 不超过 0.5 个视盘面积;C. 0.5 至 1.0 个视盘面积;D. 1.0 至 1.5 个视盘面积;E. 1.5 至 2.0 个视盘面积;F. 超过 2.0 个视盘面积。 -
L3d:病变计数
请根据图像与问题选择最合适的选项,并直接回答选项字母。
问题: 图像中可以看到多少处出血?
选项: A. 图像中未见;B. 不超过 5 处;C. 5 至 15 处;D. 15 至 25 处;E. 25 至 35 处;F. 超过 35 处。
层级 4(L4):疾病诊断
-
L4a:二分类疾病诊断
请根据图像与问题选择最合适的选项,并直接回答选项字母。
问题: 这幅眼底图像是否显示任何疾病征象?
选项: A. 是;B. 否。 -
L4b:多疾病诊断
请根据图像与问题选择所有合适的选项;如有必要,请用逗号分隔选项字母并直接作答。
问题: 这幅眼底图像显示了哪些具体异常?
选项: A. 无异常;B. 视网膜色素变性;C. 视网膜静脉阻塞;D. 视网膜动脉阻塞;E. 糖尿病视网膜病变。 -
L4c:糖尿病视网膜病变分级
请根据图像与问题选择最合适的选项,并直接回答选项字母。
问题: 给定眼底图像显示的是哪一期糖尿病视网膜病变?
选项: A. 增殖期糖尿病视网膜病变;B. 轻度非增殖期糖尿病视网膜病变;C. 重度非增殖期糖尿病视网膜病变;D. 无糖尿病视网膜病变;E. 中度非增殖期糖尿病视网膜病变。 -
L4d:年龄相关性黄斑变性分类
请根据图像与问题选择最合适的选项,并直接回答选项字母。
问题: 所示眼底图像属于哪一类年龄相关性黄斑变性?
选项: A. 早期年龄相关性黄斑变性;B. 中期年龄相关性黄斑变性;C. 无年龄相关性黄斑变性;D. 晚期年龄相关性黄斑变性。
准确的已发布任务定义可在 FunBench 数据集中查看。3
4.2.2 数据来源
FunBench 改编自以下 14 个公开数据集:1
- 六个 CFP 数据集: IDRiD、DDR、JSIEC、RFMiD、OIA-ODIR、Retinal-Lesions
- 五个 OCT 数据集: OCTDL、NEH、OCTID、UCSD、RETOUCH
- 一个 UWF 数据集: TOP
- 两个多模态数据集: MMC-AMD(CFP + OCT)和 DeepDRiD(CFP + UWF)
表 1. FunBench 统计信息:四个任务层级共包含 16,348 幅眼底图像和 91,810 个视觉问题。 改编自论文表 1。1
| 层级 | 单选问题 | 多选问题 | 示例问题 | 数据来源 |
|---|---|---|---|---|
| L1 任务:2 | 32,696 | 0 | 这幅图像采用什么方法采集? A. 磁共振成像 B. 超广角眼底摄影 C. 彩色眼底摄影 D. 光学相干断层扫描 | 所有数据集 |
| L2 任务:2 | 10,980 | 0 | 这幅图像显示的是左眼还是右眼? A. 右眼 B. 左眼 | CFP: DDR、DeepDRiD、IDRiD、OIA-ODIR、Retinal-Lesions UWF: TOP CFP + UWF: DeepDRiD |
| L3 任务:4 子任务:39 | 15,606 | 7,237 | 眼底图像中的出血位于哪些位置? A. 视盘中心鼻侧 B. 视盘中心颞侧 C. 视盘中心上方 D. 视盘中心下方 E. 图像中未见 | CFP: DDR、IDRiD、Retinal-Lesions OCT: RETOUCH |
| L4 任务:4 | 20,177 | 5,114 | 这幅眼底图像中可见哪些异常? A. 青光眼 B. 糖尿病视网膜病变 C. 无异常 D. 年龄相关性黄斑变性 E. 高血压性视网膜病变 | CFP: DDR、IDRiD、OIA-ODIR、JSIEC、RFMiD、Retinal-Lesions OCT: NEH、OCTDL、OCTID、UCSD UWF: TOP CFP + OCT: MMC-AMD CFP + UWF: DeepDRiD |
4.3 针对性评估模式
为评估 MLLM 及其两个关键模块——LLM 与 VE——作者以自底向上的方式提出了三种针对性评估模式(E-mode)。1(图 1)
E-mode I:基于线性探测的 VE 评估
如图 1b 所示,线性探测利用特定任务的开发集,为每个任务或子任务训练一个线性分类头。1
作者省略了不能直接作为分类问题处理的任务,例如 L3b、L3c 和 L3d;也省略了对线性探测而言过于简单的任务,例如 L1a 和 L1b。
E-mode II:知识提示式 LLM 评估
给定一幅测试图像及其对应的特定任务标签后,作者通过查询专家知识库 EyeWiki,将标签转换为间接描述。随后,该描述会与图像和问题一同提供给模型。1 8
示例:L2b 左右眼别识别
请根据图像、描述与问题选择最合适的选项,并直接回答选项字母。
描述: 眼底图像中的中央凹位于视盘左侧。
问题: 这幅图像显示的是左眼还是右眼?
选项: A. 左眼;B. 右眼。
说明性示例:L3a 硬性渗出识别
请根据图像、描述与问题选择最合适的选项,并直接回答选项字母。
描述: 眼底图像显示边界清晰的白色或黄色沉积物。
问题: 这幅眼底图像是否显示硬性渗出的证据?
选项: A. 否;B. 是。
上述示例使用论文给出的硬性渗出描述,展示提示词结构。1
E-mode III:整体评估
该模式对 MLLM 进行端到端评估。1
4.4 性能指标
作者报告敏感度和特异度的调和平均数,并将其称为“F1”:
对于 DR 分级(L4c)等多分类任务,作者以各类别得分的平均值作为任务级得分。1
5. 在 FunBench 上评估 MLLM
5.1 MLLM 的选择
作者选择了 7B/8B 规模的 MLLM,包括六个通用模型和三个医学模型,如表 2 所示。此外,作者还加入 GPT-4o 作为闭源基线,并加入 DINOv2-large 作为 VE 基线。1
表 2. 论文所评估的开源 MLLM。医学模型以 * 标记。 1(表 2)
| MLLM | Hugging Face 发布时间 | VE | LLM |
|---|---|---|---|
| LLaVA-v1.5-7B | 2023.10 | CLIP-ViT | Vicuna-7B |
| *Qilin-Med-VL-Chat | 2023.12 | CLIP-ViT | Chinese-LLaMA2 |
| LLaVA-v1.6-7B | 2024.01 | CLIP-ViT | Vicuna-7B |
| *LLaVA-Med-v1.5-7B | 2024.05 | CLIP-ViT | Mistral-7B |
| Qwen2-VL-7B | 2024.09 | Qwen2-ViT | Qwen2-7B |
| InternVL2.5-8B | 2024.12 | InternViT | InternLM2.5-7B |
| *HuatuoGPT-Vision-7B | 2024.06 | CLIP-ViT | Qwen2-7B |
| Janus-Pro-7B | 2025.01 | ViT-SigLIP | DeepSeek-LLM-7B |
| Qwen2.5-VL-7B | 2025.01 | Qwen2.5-ViT | Qwen2.5-7B |
5.2 结果
表 3. FunBench 评估结果。 在每种评估模式内,各列最高值(包括并列最高值)以红色粗体标出,低于随机猜测基线的数值以灰色显示。1(表 3)
| 模型 | 整体表现 | L1:成像模态 | L2:解剖 | L3:病变 | L4:疾病 | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 平均值 | L1 | L2 | L3 | L4 | L1a | L1b | L2a | L2b | L3a | L3b | L3c | L3d | L4a | L4b | L4c | L4d | |
| 随机猜测 | 0.393 | 0.313 | 0.500 | 0.361 | 0.397 | 0.250 | 0.375 | 0.500 | 0.500 | 0.468 | 0.458 | 0.250 | 0.269 | 0.500 | 0.398 | 0.319 | 0.372 |
| E-mode I: | |||||||||||||||||
| CLIP-ViT | 0.578 | - | 0.820 | 0.373 | 0.541 | - | - | - | 0.820 | 0.373 | - | - | - | 0.814 | 0.175 | 0.556 | 0.621 |
| Qwen2-ViT | 0.597 | - | 0.892 | 0.338 | 0.560 | - | - | - | 0.892 | 0.338 | - | - | - | 0.814 | 0.225 | 0.506 | 0.694 |
| InternViT | 0.614 | - | 0.932 | 0.392 | 0.517 | - | - | - | 0.932 | 0.392 | - | - | - | 0.815 | 0.230 | 0.530 | 0.491 |
| ViT-SigLIP | 0.619 | - | 0.880 | 0.398 | 0.581 | - | - | - | 0.880 | 0.398 | - | - | - | 0.833 | 0.293 | 0.528 | 0.669 |
| Qwen2.5-ViT | 0.651 | - | 0.932 | 0.449 | 0.573 | - | - | - | 0.932 | 0.449 | - | - | - | 0.812 | 0.319 | 0.514 | 0.645 |
| DINOv2-large | 0.655 | - | 0.939 | 0.408 | 0.616 | - | - | - | 0.939 | 0.408 | - | - | - | 0.858 | 0.371 | 0.568 | 0.669 |
| E-mode II: | |||||||||||||||||
| Janus-Pro | 0.409 | - | 0.560 | 0.213 | 0.454 | - | - | - | 0.560 | 0.213 | - | - | - | - | 0.517 | 0.446 | 0.401 |
| Qilin-Med-VL | 0.473 | - | 0.473 | 0.519 | 0.426 | - | - | - | 0.473 | 0.519 | - | - | - | - | 0.552 | 0.391 | 0.334 |
| LLaVA-v1.5 | 0.487 | - | 0.386 | 0.560 | 0.515 | - | - | - | 0.386 | 0.560 | - | - | - | - | 0.521 | 0.557 | 0.467 |
| LLaVA-Med-v1.5 | 0.529 | - | 0.483 | 0.507 | 0.597 | - | - | - | 0.483 | 0.507 | - | - | - | - | 0.638 | 0.640 | 0.513 |
| LLaVA-v1.6 | 0.604 | - | 0.502 | 0.717 | 0.594 | - | - | - | 0.502 | 0.717 | - | - | - | - | 0.606 | 0.647 | 0.529 |
| Qwen2.5-VL | 0.654 | - | 0.497 | 0.735 | 0.729 | - | - | - | 0.497 | 0.735 | - | - | - | - | 0.757 | 0.726 | 0.704 |
| Qwen2-VL | 0.673 | - | 0.488 | 0.747 | 0.783 | - | - | - | 0.488 | 0.747 | - | - | - | - | 0.750 | 0.855 | 0.743 |
| HuatuoGPT-V | 0.692 | - | 0.541 | 0.706 | 0.829 | - | - | - | 0.541 | 0.706 | - | - | - | - | 0.793 | 0.927 | 0.768 |
| InternVL2.5 | 0.703 | - | 0.488 | 0.831 | 0.789 | - | - | - | 0.488 | 0.831 | - | - | - | - | 0.792 | 0.929 | 0.647 |
| E-mode III: | |||||||||||||||||
| Janus-Pro | 0.355 | 0.777 | 0.167 | 0.108 | 0.369 | 0.943 | 0.611 | 0.189 | 0.145 | 0.115 | 0.203 | 0.060 | 0.055 | 0.523 | 0.319 | 0.278 | 0.358 |
| LLaVA-v1.5 | 0.418 | 0.722 | 0.489 | 0.165 | 0.296 | 0.974 | 0.470 | 0.492 | 0.485 | 0.276 | 0.266 | 0.013 | 0.104 | 0.364 | 0.292 | 0.187 | 0.341 |
| Qilin-Med-VL | 0.426 | 0.651 | 0.496 | 0.211 | 0.347 | 0.910 | 0.392 | 0.504 | 0.489 | 0.463 | 0.361 | 0.000 | 0.019 | 0.491 | 0.354 | 0.214 | 0.328 |
| LLaVA-v1.6 | 0.435 | 0.777 | 0.449 | 0.194 | 0.319 | 0.970 | 0.585 | 0.400 | 0.497 | 0.461 | 0.243 | 0.058 | 0.013 | 0.357 | 0.314 | 0.289 | 0.315 |
| LLaVA-Med-v1.5 | 0.440 | 0.813 | 0.507 | 0.215 | 0.223 | 0.961 | 0.665 | 0.502 | 0.512 | 0.166 | 0.349 | 0.261 | 0.086 | 0.000 | 0.255 | 0.290 | 0.345 |
| Qwen2.5-VL | 0.480 | 0.942 | 0.364 | 0.231 | 0.384 | 0.978 | 0.906 | 0.310 | 0.417 | 0.386 | 0.242 | 0.218 | 0.077 | 0.532 | 0.394 | 0.303 | 0.308 |
| InternVL2.5 | 0.506 | 0.946 | 0.564 | 0.244 | 0.269 | 0.997 | 0.894 | 0.640 | 0.488 | 0.391 | 0.144 | 0.227 | 0.213 | 0.031 | 0.400 | 0.294 | 0.351 |
| Qwen2-VL | 0.520 | 0.925 | 0.497 | 0.316 | 0.343 | 0.995 | 0.855 | 0.506 | 0.488 | 0.503 | 0.432 | 0.073 | 0.255 | 0.508 | 0.352 | 0.202 | 0.311 |
| HuatuoGPT-V | 0.523 | 0.933 | 0.309 | 0.374 | 0.477 | 0.961 | 0.905 | 0.140 | 0.477 | 0.548 | 0.379 | 0.338 | 0.231 | 0.622 | 0.504 | 0.414 | 0.369 |
| GPT-4o | 0.542 | 0.961 | 0.535 | 0.341 | 0.331 | 0.965 | 0.957 | 0.557 | 0.514 | 0.362 | 0.412 | 0.361 | 0.228 | 0.018 | 0.452 | 0.476 | 0.378 |
VE 对比
不同 VE 的表现见表 3 的 E-mode I 部分。1
主要结果如下:
- 在所测试的冻结编码器线性探测协议及聚合评分流程下,DINOv2 是表现最佳的 VE,而 CLIP-ViT 在所评估编码器中得分最低。
- VE 在 L4b 上的表现甚至低于随机水平。
作者将这些结果解释为纯视觉方案在眼底图像分析上存在局限的证据。
LLM 对比
作者进行的知识提示式 LLM 评估结果见表 3 的 E-mode II 部分。1
主要结果如下:
- 作者认为,InternVL2.5、HuatuoGPT-Vision 和 Qwen 在知识提示条件下的表现强于其对应 VE,这表明它们的 LLM 具备与眼底图像解读相关的眼科知识。
- 各模型在不同任务上的表现不一致:它们在 DR 分级(L4c)上的表现优于 AMD 分类(L4d)。
- L2b 的表现接近随机水平。
作者对第二项结果的解释是:网络上的 DR 相关材料可能比 AMD 相关材料更丰富,因此 LLM 更熟悉 DR。对于 L2b 表现不佳,尽管这是一个简单任务,作者认为这种技能可能过于基础,很少被专门讨论,因此相关训练数据较少。
作者据此认为,结果揭示了当前数据驱动范式的一项根本局限:它会生成能力强大的模型,却未必具备基础的眼底图像解读技能。
MLLM 对比
MLLM 的表现汇总于表 3 的最后一部分。1
- 在所测试的开源 MLLM 中,HuatuoGPT-Vision 表现最佳,其后是 Qwen2-VL 和 InternVL2.5;若计入闭源基线,GPT-4o 的总体得分最高。
- HuatuoGPT-Vision 与 Qwen2-VL 使用相同架构的 LLM——Qwen2-7B,但前者的 VE(CLIP-ViT)在线性探测评估中的表现不如后者的 VE(Qwen2-ViT)。作者将 HuatuoGPT-Vision 更强的整体表现视为领域特异性微调重要性的证据。
- 表 4 显示,整体表现与知识提示条件下表现的排名相关性,远高于整体表现与 VE 线性探测表现的排名相关性。作者据此认为,所评估的 MLLM 在眼底图像解读中高度依赖其内部 LLM。
作者指出,所评估 MLLM 的眼底图像解读能力相当有限,并认为相关性分析凸显了开发强大眼科 LLM 的迫切需求。
表 4. 基于平均性能排名的相关性分析。 1(表 4)
| 模块 | 与 MLLM 的 Spearman 相关系数 |
|---|---|
| LLM | 0.917 |
| VE | 0.055 |
5.3 作者的结论
- 所评估的 MLLM 在涉及解剖感知、病变分析和疾病诊断的眼底图像解读任务上仍然较弱。
- 所评估的 MLLM 对 LLM 的依赖高于 VE。
- 在线性探测评估中,这些 MLLM 使用的 VE 不如 DINOv2 有效。
- HuatuoGPT-Vision 在开源模型中的领先表现说明了领域特异性训练的重要性。
- 未来的训练流程需要考虑完整的眼底图像解读技能范围,否则我们可能会开发出缺乏基础眼底图像解读能力的 MLLM。1
6. 我的评论
我认为 FunBench 的价值在于,它能够超越单一诊断分数,评估眼底图像解读的多种技能。我们可以利用其任务评估自己的模型,将框架改造后用于智能体工作流,并把这种方法扩展到其他领域。公开的代码与标注使这些工作更容易开展,不过原始图像的准备和模型集成仍然需要额外工作。2 3
此外,还有几个问题值得注意。
在 2026 年 10 月 2 日检查的公开仓库版本中,我没有找到 E-mode I 的特征提取与线性探测训练流程(见 issue #2)。这使论文的模块化评估复现仍有一处缺口。
作者对结果的解释与假设还不够有说服力。
例如,作者认为 AMD 表现差于 DR 与相关训练材料的相对数量有关。观察到的性能差异确实能启发这一假设,但论文没有直接证据说明模型训练数据中 DR 与 AMD 的相对覆盖程度。图像难度、类别定义和问题设计的差异仍然可能是替代解释。
我也不确信,左右眼别识别表现不佳主要是因为缺少相关训练样本。图像坐标、解剖学眼别和观察视角的歧义,也可能是误差来源。线性探测在眼别识别上的表现相对较好,说明视觉特征中可以读出有效信息,因此我也会检查连接器、提示词理解和答案映射。测试明确的坐标约定和受控的水平翻转,有助于定位问题。
我最关心的是将性能归因于各个模块。E-mode II 同时提供图像和由参考标签派生的描述,因此其得分衡量的是在已经给出正确语义线索的条件下,模型的作答表现;而 E-mode I 衡量的是对视觉特征进行有监督线性读出的表现。这些模式在输入、监督方式和任务覆盖范围上都存在差异。我认为,仅凭它们的得分或与整体表现的相关性,不足以证明 LLM 的贡献大于 VE。1 8
仅提供描述的条件,再结合空白或打乱的图像,可以帮助衡量提供描述时图像的贡献。作者认为,纯文本测试未必能反映 LLM 经多模态适配后的行为;我仍会将其作为补充对照。由未接触参考标签的专家撰写描述,以及受控的模块替换实验,也能为归因提供进一步证据。
同样的归因问题也影响了关于微调的论断:HuatuoGPT-Vision 和 Qwen2-VL 在多个系统组件和训练选择上存在差异,因此两者的比较无法隔离领域特异性训练的效果。同样,较弱的线性探测结果表明的是所测试表征与读出协议的局限,而非所有纯视觉方法的局限。
总体而言,我重视这一分层任务框架,但认为模块归因的证据不够有说服力。端到端评估与实际基于图像的眼底解读更直接相关。
参考文献
- Wei, Q., Qian, K., and Li, X. FunBench: Benchmarking Fundus Reading Skills of MLLMs. MICCAI 2025, LNCS 15965, pp. 278–288. DOI · 开放获取稿件。
- RUC AIMC Lab. FunBench 源代码与准备说明。 代码仓库。
- AIMClab-RUC. FunBench VQA 标注。 Hugging Face 数据集。
- Hu, Y., et al. OmniMedVQA: A New Large-Scale Comprehensive Evaluation Benchmark for Medical LVLM. CVPR 2024. 会议论文页面。
- Chen, P., et al. GMAI-MMBench: A Comprehensive Multimodal Evaluation Benchmark Towards General Medical AI. NeurIPS 2024. 会议论文页面。
- Qin, Z., et al. LMOD: A Large Multimodal Ophthalmology Dataset and Benchmark for Large Vision-Language Models. Findings of NAACL 2025. ACL Anthology。
- RUC AIMC Lab.
evaluate.py。 固定版本源代码。 - RUC AIMC Lab.
predict.py。 固定版本源代码。 - 关于
emod1评估的提问。 FunBench GitHub issue #2。Issue。
评论
登录 — 登录后参与讨论。